Benchmark v2 · catalog 层 · 更新于 2026-10-10 08:04 UTC
理论能否预言 catalog 里每个源的 DET_ML?
这一页用图解释 v2 在比什么、怎么打分、现在的结果,以及从 v1 到 v2 改进了什么。只看结论的话,读下面的方框。
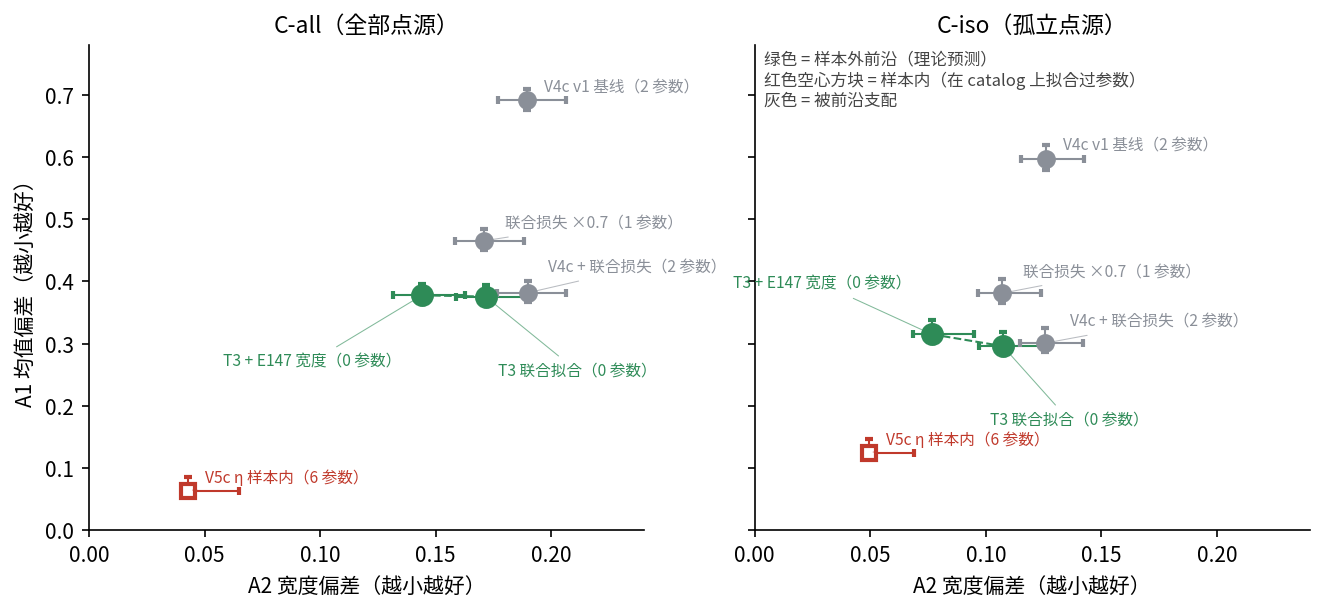
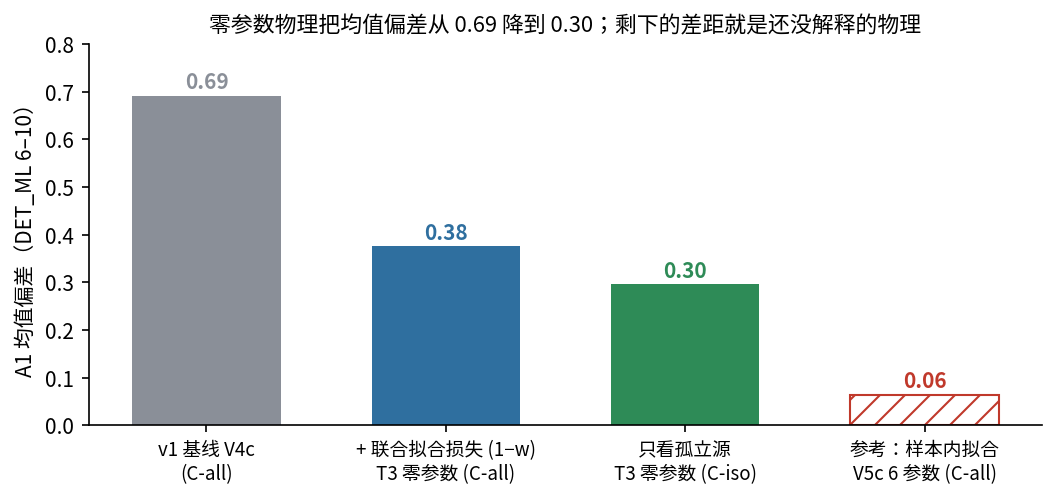
一句话结论。不用任何在 catalog 上拟合的参数,只靠物理推导(单图像理论 + 多相机联合拟合的位置共享损失), DR14 M2 波段 4 点源在检测阈值附近(DET_ML 6–10)的 ΔC 均值偏差从 v1 基线的 0.69σ 降到 0.38σ; 只看理论适用的孤立点源,则为 0.30σ(v1 基线在孤立点源上是 0.60σ)。
剩下的 0.3σ 已经部分找到原因(背景估计误差使宽度变宽;MOS 有约 2–6% 的比例亏缺),正在研究。 拟合了 6 个参数的 V5c 能做到 0.06σ,但它是"样本内",不能算理论成功——我们的目标是用零参数物理达到它。
第 1 步
这个 benchmark 在测什么
emldetect 给每个源一个检测似然 DET_ML。它和似然比统计量 ΔC 一一对应:DET_ML = −ln Q(3/2, ΔC/2)。
所以"预言 DET_ML"等价于"预言 ΔC 的分布"。
- 理论只能用可观测量:拟合计数 Ŝ、背景 b、源的位置(偏轴角),以及一个事先声明的源计数先验 π。 真实流量在 catalog 里不可知,所以不允许用。
- 理论给出两样东西:这个源的 ΔC 的预测均值和预测宽度(标准差)。
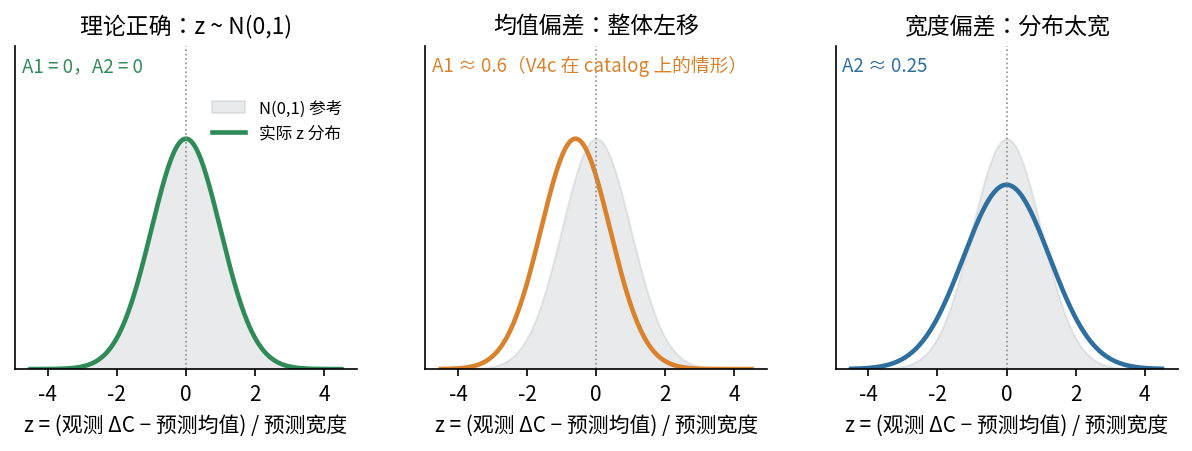
- 把每个源换算成 z:z = (观测 ΔC − 预测均值) / 预测宽度。理论正确时,所有源的 z 应服从标准正态分布 N(0,1)。
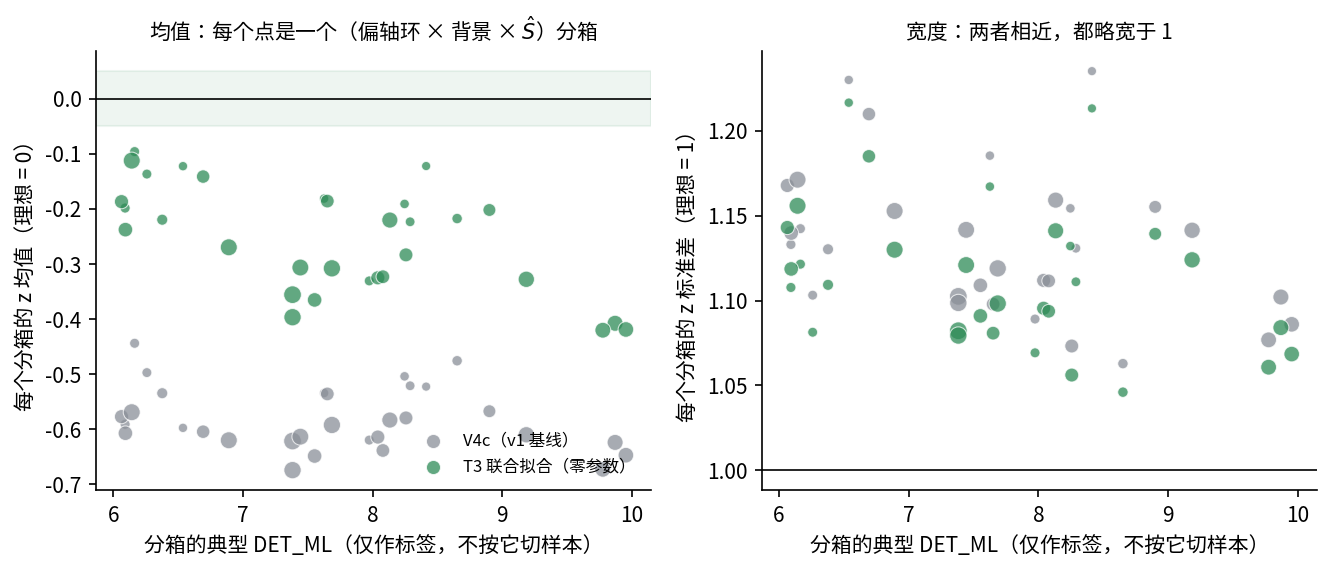
- 按可观测量分箱检查:偏轴环 × 背景切片 × Ŝ,每箱至少 200 个源。绝不按 DET_ML 本身切样本(那会人为制造偏差)。 重点看典型 DET_ML 在 6–10 的分箱,也就是检测阈值附近;这里的误差直接影响 catalog 的完备度和通量偏差修正。
第 2 步
怎么打分:三个误差分数 + 参数个数
- A1 均值偏差:各分箱 z 均值的均方根(按源数加权)。0 = 完美;0.3 表示典型分箱的均值偏了 0.3 个标准差。
- A2 宽度偏差:各分箱 (z 的标准差 − 1) 的均方根。0 = 宽度完全对。
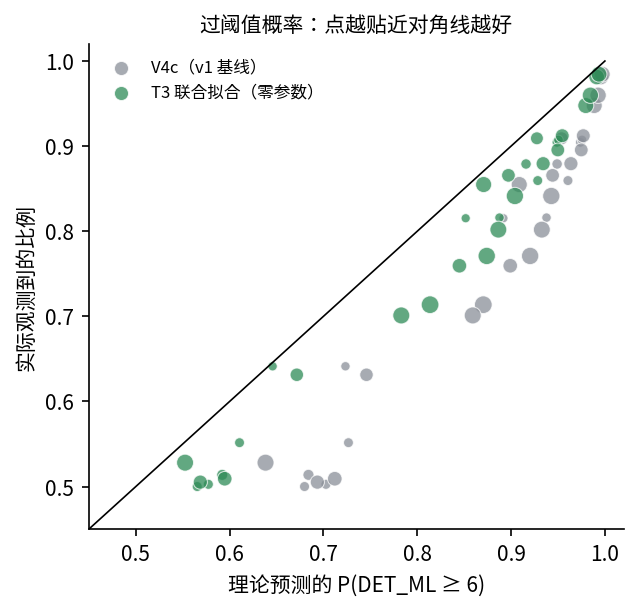
- A3 过阈值概率误差:理论预测"DET_ML ≥ 6(或 8、10)"的概率,减去实际观测到的比例,取均方根。这是 catalog 用户最关心的量。
- A4 参数个数:模型里在数据上拟合出来的数有几个。越少越好。
噪声校正。即使理论完美,有限样本也会让 A1、A2 有一个"噪声底"。表中给的是扣掉噪声底后的值 √(原始² − 噪声底²)。比较两个模型时,用"两级自助法"(先按观测重采样,再在观测内重采样)给出 95% 区间;差别落在区间内就算打平。
前沿(Pareto)。如果模型甲在 A1、A2、A3 上都不比乙差,并且至少一项更好,就说甲"支配"乙。没有被支配的模型组成前沿。 在噪声内打平时,参数少的优先。
样本内 vs 样本外。在 catalog 上拟合过参数的模型(如 V5c,6 个参数)分数天然好看,单独成一个"样本内"前沿。 论文的 catalog 结论必须来自"样本外"模型,也就是参数没碰过这批数据的模型。另外,三分之一的位置被预先留出不公开,只在里程碑时打开,用来检验是否过拟合。
第 3 步
现在的结果
两个 catalog 层:C-all 是 v1 用的全部 DR14 M2 波段 4 点源;C-iso 只保留孤立点源(2′ 内没有展源,最近邻 ≥ 60″)。 理论描述的是孤立点源,所以 C-iso 是检验理论的主要层。我们发现最内环(0–4′)的大部分亏缺来自拥挤或展源邻居,不是理论的问题。
| 层 | 模型 | 参数 | A1 均值 | A2 宽度 | A3 过阈值 | 窗口源数 |
|---|---|---|---|---|---|---|
| C-iso | T3 联合拟合(零参数) 样本外前沿单图像理论 + 联合拟合损失 (1−w) + c20 宽度律。没有任何在 catalog 上拟合的数。 | 0 | 0.296 | 0.107 | 0.078 | 18,771 |
| C-iso | V4c + 联合拟合损失 在 V4c 上加入多相机联合拟合的位置共享损失 (1−w)。 | 2 | 0.301 | 0.126 | 0.079 | 18,771 |
| C-iso | T3 + E147 宽度(零参数) 样本外前沿同 T3,但宽度用 E147 混合律。没有任何在 catalog 上拟合的数。 | 0 | 0.315 | 0.077 | 0.084 | 18,771 |
| C-iso | 联合损失 ×0.7 联合拟合损失乘 0.7 的变体(1 个参数)。 | 1 | 0.381 | 0.107 | 0.100 | 18,771 |
| C-iso | V4c(v1 基线) v1 留下的单图像理论:均值 μ+δ,宽度 V4c 律。2 个早期参数。 | 2 | 0.597 | 0.126 | 0.152 | 18,771 |
| C-iso | V5c η(样本内,6 参数) 样本内在 catalog 行上拟合了 6 个修正数(η 层)。分数好看,但属于样本内,不能当作理论成功。 | 6 | 0.125 | 0.049 | 0.035 | 18,771 |
| C-all | T3 联合拟合(零参数) 样本外前沿单图像理论 + 联合拟合损失 (1−w) + c20 宽度律。没有任何在 catalog 上拟合的数。 | 0 | 0.375 | 0.172 | 0.095 | 33,683 |
| C-all | T3 + E147 宽度(零参数) 样本外前沿同 T3,但宽度用 E147 混合律。没有任何在 catalog 上拟合的数。 | 0 | 0.378 | 0.144 | 0.097 | 33,683 |
| C-all | V4c + 联合拟合损失 在 V4c 上加入多相机联合拟合的位置共享损失 (1−w)。 | 2 | 0.382 | 0.190 | 0.095 | 33,683 |
| C-all | 联合损失 ×0.7 联合拟合损失乘 0.7 的变体(1 个参数)。 | 1 | 0.465 | 0.171 | 0.117 | 33,683 |
| C-all | V4c(v1 基线) v1 留下的单图像理论:均值 μ+δ,宽度 V4c 律。2 个早期参数。 | 2 | 0.691 | 0.190 | 0.169 | 33,683 |
| C-all | V5c η(样本内,6 参数) 样本内在 catalog 行上拟合了 6 个修正数(η 层)。分数好看,但属于样本内,不能当作理论成功。 | 6 | 0.063 | 0.043 | 0.018 | 33,683 |
数值都是噪声校正后的点值,只用公开位置。带区间的完整英文表见 v2 详细表。
第 4 步
改进具体体现在哪里:逐分箱看
下面两张图打开了 A1 和 A3 这两个汇总数,直接看每个分箱。数据是 C-iso 的 M2 波段 4 开发数据,即 T11 第 3 阶段的分箱表。
第 5 步
从 v1 到 v2 改了什么、为什么改
| 问题 | v1 的做法 | v2 的做法 | 为什么 |
|---|---|---|---|
| 源计数先验 | 没有声明,隐含在模拟设计里(约 α≈1) | 明确声明先验 π,在 α = 0…2.5 与天空先验下都评分 | 我们证明了 ΔC 的条件均值依赖先验,宽度不依赖;不声明先验,"均值误差"就说不清。 |
| 噪声 | 直接比原始分数 | 扣除噪声底,并用区间判定打平 | v1 有几组排名其实落在噪声里。 |
| 重采样单元 | 按分箱 | 两级:先按位置或观测,再在其内部 | 同一幅图像或同一次观测里的源不独立;位置之间也不可互换(位置差异约为图像噪声的 4 倍)。 |
| 过阈值概率 | 不评 | 新增 A3 | catalog 用户关心的是"能不能过阈值"。 |
| 过拟合 | 全部数据公开 | 三分之一位置预先留出 | 防止针对公开数据调参。 |
| 参数 | 不分样本内外 | 参数计数;样本内与样本外分开成前沿 | 在 catalog 上拟合过的模型不能证明理论正确。 |
| catalog 人群 | 全部点源 | 另设孤立点源层 C-iso | 理论描述孤立点源;拥挤环境会额外压低 ΔC。 |
| 模拟检验 | 只有 emldetect 模拟 | 新增 L0(理想拟合器)、L1(emldetect 对理想拟合器)、J(多相机联合) | 把"理论对不对"和"emldetect 的工程细节"分开。L1 已证明 emldetect 走的是局部最优,v2 据此改为以局部最优计分。 |
第 6 步
到目前为止学到的物理
- 多相机联合拟合的位置共享损失 (1−w):零参数,在 14 个相机-波段上都成立,去掉 24–57% 的均值偏差。
- 最内环亏缺来自环境:2′ 内有展源时残差为 −1.0 到 −2.0σ,没有时为 −0.2 到 −0.8σ,所以引入了 C-iso。
- PN 的宽度偏大来自背景估计误差:宽度超出随曝光变长而增大;"背景误差律"能样本外预测 PN 波段 3、4 的宽度(R² 0.73–0.88)。 初步模拟显示,DR14 的样条背景在源位置偏高(中位数约 9%,样本还小,正在扩大)。
- MOS 的均值亏缺约为 μ 的 2–6%:在源主导的情形更大,指向 PSF 或有效面积通道,正在用 CCF 的 PSF 做零参数检验。
- V5c 的 6 个参数吸收的正是上面这些效应。我们的目标是用推导出来的物理项逐一替代它们。
接下来
还没上线的部分
- L0(理想拟合器):336 万个模拟源,S 连续、随机抽样并记录真值,正在 virgo 上生产,预计约 4 天。完成后检验理论本身,不受工程细节影响。
- L1(emldetect 对理想拟合器,逐行配对):16,200 幅图,生产中,预计约 6 天。它量化 emldetect 与理想拟合之间的差。
- J(多相机联合模拟):包括真实的背景估计流程,用来定量背景误差。
- 私有位置只在里程碑时由你决定打开。